
一次 LLM API 调用,背后到底发生了什么?
本文已发表于 InfoQ 。
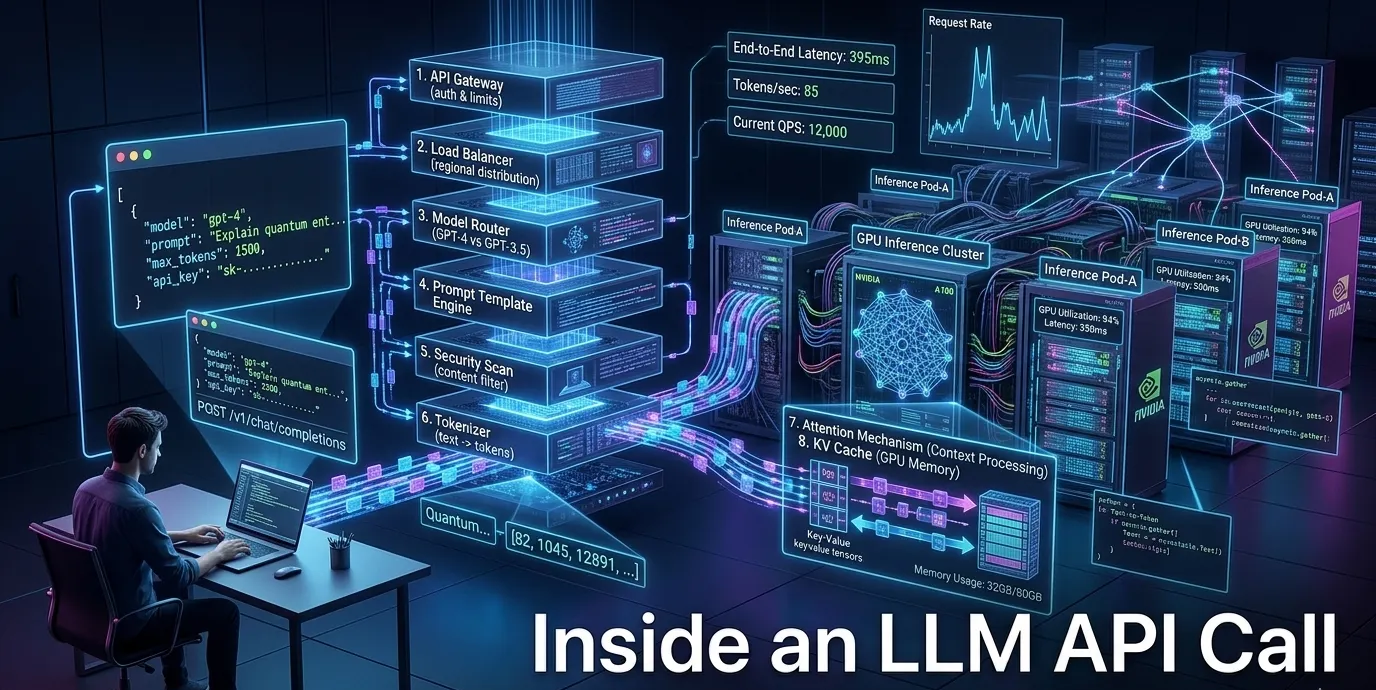
从 Tokenization、Routing 到 Prefill、Decode、KV Cache 与 Billing
你输入一句:
帮我分析一下这份报告。
点击发送。
过了一会儿,答案出现在屏幕上。
对于大多数使用者来说,这个过程很简单。API 接收请求,模型生成答案,客户端把结果显示出来。一行代码就能完成。
真正运行起来,事情要复杂得多。
一个生产环境中的 LLM API,前面连着网络、认证、限流和路由,后面连着 Token 计量、Safety、Streaming 和 Observability。进入模型之后,又会涉及 Prefill、Decode、KV Cache、GPU Memory、Batching 等一系列计算和调度机制。
如果模型支持 Reasoning、Web Search、Code Execution 或其他工具,一次请求还可能在模型和外部工具之间来回几轮。
可以把它看成一条完整的 AI Serving Pipeline。
下面这套流程主要用于理解一个典型的文本生成请求。不同 Provider、模型和部署架构之间会有差别,有些环节可能合并,有些则会拆成独立服务。
01、请求从哪里开始?
先从 API Gateway 说起。
客户端发出的请求,大致会经过:
Client
  ↓
Network / TLS
  ↓
API Gateway / Edge
  ↓
Authentication
  ↓
Request Validation
  ↓
Rate Limiting
  ↓
Usage Accounting
这里处理的事情都比较熟悉。
TLS 负责安全连接,Authentication 判断调用者有没有权限,请求验证检查参数和格式,Rate Limiting 控制访问速度。与此同时,系统还需要建立这次请求的 Usage 信息,后面才能知道用了多少 Token、产生了多少费用。
限流也比“每分钟最多调用多少次”稍微复杂一些。
实际 API 通常同时存在 RPM、TPM、并发量、项目级限制、模型级限制等约束。不同服务商的具体规则不同。
因此,一个:
429 Too Many Requests未必意味着模型本身出了问题。
它可能只是说明,当前请求触碰到了某一层容量限制。
02、请求接下来去哪里?
传统 Web 服务里,我们很容易把这一层理解成 Load Balancer:
              Load Balancer
              /     |     \
             ↓      ↓      ↓
          Server  Server  Server
LLM Serving 的调度通常要考虑更多事情。
系统需要知道请求使用哪个模型、哪个 Region、哪个 Replica,以及当前各个 Worker 的负载和队列情况。
对于现代推理系统,还可能进一步考虑:
- KV Cache 是否已经存在
- Prefill Worker 的状态
- Decode Worker 的状态
- GPU 和节点之间的拓扑
- 数据传输成本
- 当前模型的可用容量
因此,现在谈这一层,用 Routing & Scheduling 更合适。
尤其值得注意的是 KV Cache。
假设某个 Worker 已经保存了大量与你当前请求相同的上下文,把新的请求送到那里,就有机会复用已有的 Cache。换一台 GPU,则可能需要重新计算。
于是,“请求发给谁”逐渐和“Cache 在哪里”联系在了一起。
NVIDIA Dynamo 等现代 Serving 系统已经提供 KV-aware routing、Prefill/Decode Disaggregation 等能力。
03、模型看到的并不是文字
接下来是 Tokenization。
你输入:
帮我分析一下这份报告Tokenizer 会把它转换成模型能够处理的 Token IDs:
Text
 ↓
Tokenizer
 ↓
Token IDs
 ↓
[ ... ]
不同模型使用的 tokenizer 并不完全相同。BPE、SentencePiece、WordPiece 都属于常见方案。
因此,同一句话交给不同模型,得到的 Token 数量可能不同。
Token 数量很重要。
它关系到 Context Window,也会影响计算量、延迟和费用。
经常有人用:
1 Token ≈ 4 个字符
来帮助理解 Token。
这个经验值对于英文文本可以提供一点直觉,放到中文、代码、JSON 或数学表达式里就不太可靠了。真正的 Token 数量,还是应该交给对应模型的 tokenizer 来计算。
04、Context Window 是怎么参与进来的?
Tokenization 完成之后,系统还需要检查这次请求是否符合模型的上下文限制。
Context 里装的东西,远不止用户刚刚输入的那句话。
它可能包括:
System Prompt + Conversation History + User Input + Tool Definitions + Retrieved Documents +
Previous Tool Results
对于 Agent,这个列表还会不断增长。
因此,“我只输入了 2000 个字”并不能直接说明这次请求用了多少 Context。
另外,Context 超限之后怎么处理,也取决于 API 的设计。有的接口允许截断历史内容,有的会直接返回错误。
Context Window 更适合被理解成:
一次推理任务可以携带的上下文预算。
05、Prefill:模型先把上下文读进去
现在才真正进入模型推理。
LLM 的生成过程通常可以分成两个重要阶段:
                Inference
                    │
          ┌─────────┴─────────┐
          ↓                   ↓
       Prefill              Decode
Prefill 可以理解成“先处理输入”。
假设 Prompt 很长:
10,000 Tokens
       ↓
    Prefill
       ↓
Attention States
       ↓
   KV Cache
模型会对这批输入 Token 进行计算,并建立后续生成所需要的中间状态。
其中非常重要的一部分,就是 Key / Value,也就是 KV Cache。
这里有一个容易产生误解的地方。
Prefill 确实可以对输入序列进行高度并行的计算,但它并不等于“10,000 个 Token 各算各的”。Transformer 的 Attention 仍然存在序列关系,实际耗时还受到模型结构、硬件利用率、Batching、Chunked Prefill 和 Cache Reuse 等因素影响。
因此,不能简单地用“10,000 Token 一定是 1,000 Token 的十倍时间”来估算。
工程系统里的实际情况会复杂一些。
06 — KV Cache:模型为什么不用每次从头算?
假设你正在和一个模型进行长对话。
每生成一个新 Token,如果都重新计算之前所有上下文,重复计算会非常可观。
KV Cache 解决的就是这一部分问题。
可以粗略地想象:
Previous Context
       ↓
   KV Cache
       ↓
    New Token
       ↓
Continue Generation
已经计算过的 Key 和 Value 被保存下来,后续生成可以继续使用。
问题也随之而来:
KV Cache 很占内存。
尤其在长上下文、高并发场景下,大量请求同时保存 KV Cache,GPU Memory 很快就会成为系统的重要资源。
于是,Serving 系统开始围绕 KV Cache 做各种优化:
- Paged KV Cache
- Prefix Caching
- KV Cache Offloading
- Distributed KV Cache
- KV-aware Routing
有些系统还会把 Cache 放在 GPU 之外,根据性能和容量需要,在 CPU Memory、SSD 或其他存储层之间进行管理。vLLM、NVIDIA NIM 等推理系统都已经提供不同形式的 KV Cache 管理和 Offloading 能力。
这也是今天 LLM Serving 很有意思的一点。
过去讨论负载均衡时,通常关心:
哪台服务器比较空?
现在还要问:
哪台服务器已经有我要的 Cache?
07、Decode:答案开始一个 Token 一个 Token 的生成
Prefill 完成之后,进入 Decode。
典型的自回归生成过程可以画成:
Prompt
  ↓
Prefill
  ↓
Token 1
  ↓
Token 2
  ↓
Token 3
  ↓
Token 4
  ↓
...
模型每一步都会根据当前上下文预测接下来的 Token。
这就是 LLM 和很多传统 API 在性能表现上的一个明显区别。
一个普通 API 往往是:
Request
  ↓
Compute
  ↓
Response
LLM 生成则更像:
Request
  ↓
Inference
  ↓
Token
  ↓
Token
  ↓
Token
  ↓
Token
  ↓
...
输出越长,生成过程通常也越长。
因此,LLM 性能分析里经常会看两个指标。
TTFT:Time To First Token
从发送请求到第一个 Token 出现,需要多久?
ITL:Inter-Token Latency
相邻 Token 之间的生成间隔是多少?
对于聊天机器人、Coding Agent 等交互式应用,这两个指标都很有意义。
一个回答总共需要 8 秒,并不代表用户要等 8 秒才能看到任何东西。如果第一个 Token 在 500ms 左右就出现,后面的内容持续流出,体验会完全不同。
08、Attention:GPU 到底在计算什么?
Decode 阶段会反复执行 Transformer 的计算。
把 Attention 极度简化之后,可以画成:
Q × Kᵀ
   ↓
Attention Scores
   ↓
Softmax
   ↓
× V
   ↓
Next Layer
现代模型中可以看到很多不同的 Attention 设计,例如:
- Multi-Head Attention(MHA)
- Multi-Query Attention(MQA)
- Grouped-Query Attention(GQA)
- FlashAttention
其中 GQA 和 MQA 会减少 Key / Value Head 的数量,从而降低 KV Cache 的内存压力。
FlashAttention 则从另一个方向优化 Attention 的计算和内存访问。
所以,LLM 推理性能很少只是一个“GPU 算力够不够”的问题。
计算能力、显存容量、Memory Bandwidth、Cache、Batching 和调度策略都会参与其中。
09、GPU 只是计算资源的一部分
大型模型通常需要多张 GPU 或其他 AI Accelerator 协同工作。
例如:
                  Model
                    │
        ┌───────────┼───────────┐
        ↓           ↓           ↓
      GPU 0       GPU 1       GPU 2
        │           │           │
        └───────────┼───────────┘
                    ↓
                 Serving
常见的并行方式包括:
- Tensor Parallelism
- Pipeline Parallelism
- Data Parallelism
- Expert Parallelism
硬件也一直在变化。H100、H200、B200,以及其他 GPU、TPU 和 AI Accelerator 都可能出现在实际 Serving 环境中。
对于推理来说,显存尤其重要。
模型权重需要放进去,KV Cache 需要放进去,中间状态也需要空间。
于是很多性能优化最后都会落到几个很朴素的问题上:
计算能不能少一点?
数据能不能少搬一点?
已经算过的东西能不能复用?
10、Prefill 和 Decode,已经可以分开运行
这是近几年 LLM Serving 架构里非常值得关注的一件事情。
最容易理解的方式,是先把整个推理过程放在一个 Worker 里:
Request
   ↓
Worker
   ↓
Prefill
   ↓
Decode
   ↓
Response
但 Prefill 和 Decode 对资源的需求并不完全相同。
Prefill 更偏计算密集。
Decode 则更容易受到 Memory Bandwidth、KV Cache 和并发调度的影响。
在高负载场景下,如果大量长 Prompt 同时进入 Prefill,它们可能影响正在进行的 Decode。
因此,一些现代 Serving 架构开始把两者拆开:
                    ┌───────────────┐
                    │ Prefill Pool  │
                    └───────┬───────┘
                            │
                         KV Cache
                            │
                            ↓
Request → Router → ┌───────────────┐
                   │  Decode Pool  │
                   └───────────────┘
Prefill Worker 负责建立 KV Cache,再把相关状态交给 Decode Worker。
这种架构叫:
Disaggregated Serving
NVIDIA Dynamo 当前文档已经把 Prefill/Decode Disaggregation 作为重要的 Serving 架构,并专门处理 KV Transfer、Worker 路由和拓扑问题。
当然,拆开以后也多了一次数据传输。
如果 KV Transfer 成为瓶颈,分离架构未必能够带来收益。
这件事情很典型:LLM Serving 的优化经常不是简单地“多加一种技术”,而是在计算、内存、网络和调度之间重新找平衡。
11、Reasoning 出现之后,一次请求可能变长了
过去讨论 LLM API,常见的模型是:
Prompt
  ↓
Answer
今天这个模型已经不太够用了。
对于支持 Reasoning 的模型,一次请求可能更接近:
Prompt
  ↓
Reasoning
  ↓
Tool Call?
  ↓
Observation
  ↓
More Reasoning
  ↓
Final Answer
用户最终看到的答案,可能只有几百个 Token。
模型在整个过程中实际处理的 Token 数量却可能更多。
现代 API 已经开始把 Reasoning Tokens 单独统计出来。
这也解释了一个经常出现的现象:
同一个问题,有时候模型很快给出答案,有时候却“思考”更久。
延迟和 Token Usage 都可能随之变化。
对于成本分析,只看最终回答有多少字,已经不够用了。
12、Tool Use 让一条 API 调用变成一段流程
再看一个稍微复杂的例子。
你问:
帮我查一下今天 NVIDIA 的股价,再分析一下上涨的原因。
如果模型可以使用工具,后台可能是:
User Prompt
     ↓
LLM
     ↓
Reasoning
     ↓
Tool Call
     ↓
External API / Web
     ↓
Tool Result
     ↓
LLM
     ↓
More Reasoning
     ↓
Final Answer
这里的时间已经不能简单理解成“模型生成答案用了多久”。
外部 API 需要多久,搜索需要多久,工具返回的数据有多少,模型需要进行几轮推理,这些都会加入整个过程。
所以在 Agent 系统里,一次用户操作经常对应一条更长的 Trace。
LLM 只是其中的一部分。
13、Safety 和 Policy 也在这条链路里
安全控制的位置并不固定在最终输出之后。
一个典型的系统可能在不同阶段进行检查:
Input
  ↓
Policy / Safety
  ↓
Model
  ↓
Tool Call
  ↓
Output
  ↓
Policy / Safety
具体实现取决于 Provider 和 API。
有的系统会在输入阶段进行检查,有的会在输出阶段进行过滤,还有的会针对工具调用增加额外的策略控制。
最终响应中还可能带有某种 termination reason,例如:
STOP
MAX_TOKENS
SAFETY
...
不过这些字段和枚举并没有统一的行业标准。
因此,在工程代码里最好按照具体 Provider 的 API 定义来处理。
14 、为什么答案会一个 Token 一个 Token 地出现?
因为 Streaming。
普通响应大致是:
Request
   ↓
████████████████
   ↓
Complete Response
Streaming 则是:
Request
   ↓
Token 1 → Client
Token 2 → Client
Token 3 → Client
Token 4 → Client
...
模型仍然在做原来的计算。
改变的是数据返回方式。
因此 Streaming 对交互体验非常重要,尤其是 Chat、Coding Assistant 和 Agent UI。用户可以更早看到结果,不必等整个 Response 完成。
这也是 TTFT 值得单独监控的原因。
15、然后,系统开始计算这次调用用了多少钱
模型生成完成之后,Usage 信息会进入计量流程。
最简单的模型可以写成:
Cost ≈

Input Tokens × Input Rate
+
Cached Tokens × Cached Rate
+
Output Tokens × Output Rate
现在实际的计费项目已经丰富得多。
可能涉及:
- Input Tokens
- Cached Input Tokens
- Output Tokens
- Reasoning Tokens
- Tool Usage
- Image / Audio 等多模态用量
- Batch / Priority / Flex 等不同服务模式
不同 Provider、模型和服务等级采用不同的计费方式。
因此,“一次 API 调用多少钱”其实没有一个脱离具体模型和服务商的固定答案。
有一点倒是非常稳定:
Token Usage 是 AI 应用成本分析里最重要的数据之一。
16、Prompt Caching 为什么越来越重要?
假设一个 Agent 每次请求都会携带:
System Prompt
+
Tool Definitions
+
Company Rules
+
Long Documentation
+
User Question
其中前面几万 Token 几乎没有变化。
如果每次都重新处理,重复计算会非常多。
Caching 的思路很直接:
First Request
     ↓
Compute
     ↓
Cache

Later Requests
     ↓
Reuse
现代 Provider 已经提供不同形式的 Prompt / Context Caching。
缓存命中以后,可以减少重复上下文带来的计算和费用;具体收益取决于模型、缓存策略和请求模式。OpenAI、Anthropic、Google 等主要 Provider 都已经提供相应机制。
对于 Agent,这个问题尤其值得关注。
因为 Agent 很容易反复携带:
- System Prompt
- Tool Schema
- Conversation History
- User Context
- Retrieved Knowledge
在长上下文应用里,Cache 的位置已经逐渐从一个局部优化手段,进入 Serving Architecture 本身。
17、有些任务,根本不需要实时完成
还有一类请求,对延迟并不敏感。
比如:
- 大规模文档分类
- Embedding
- 数据清洗
- Evaluation
- 批量摘要
- 夜间数据处理
这类任务可以考虑 Batch Processing。
实时请求追求:
Low LatencyBatch 更在意:
Resource Utilization
+
Cost
+
Throughput
目前不同 Provider 对 Batch 的价格和 SLA 有不同设计,不能简单概括成一个统一的折扣比例。
但工程上的判断很简单:
业务不需要实时的时候,没必要为实时能力支付同样的成本。
18、最后,你需要知道发生了什么
用户看到的可能只有:
分析完成。
后台却应该有足够的信息,让工程师能够回答:
为什么今天变慢了?
为什么成本突然上升?
为什么 429 增多?
为什么这个用户特别慢?
为什么 Cache 没有命中?
所以一条完整的 Trace 里,通常值得关注:
Request ID
Model
Region
Latency
TTFT
ITL
Input Tokens
Cached Tokens
Output Tokens
Reasoning Tokens
Cache Hit / Miss
Tool Calls
Errors
Retries
Rate Limits
Termination Reason
Cost
对于生产系统来说,这些数据比“模型平均响应时间 1.2 秒”有用得多。
因为真正的问题往往藏在平均值下面。
19、把整条链路重新看一遍
现在再回头看一次 LLM API 调用:
User
 │
 ↓
API Gateway / Edge
 │
 ├─ Authentication
 ├─ Validation
 ├─ Rate Limit
 └─ Usage Accounting
 │
 ↓
Routing & Scheduling
 │
 ├─ Model
 ├─ Region
 ├─ Capacity
 ├─ KV Locality
 └─ Prefill / Decode
 │
 ↓
Tokenization
 │
 ↓
Context Check
 │
 ↓
┌──────────────────────────┐
│       Inference          │
│                          │
│  Prefill → KV Cache      │
│              ↓           │
│           Decode         │
│              ↓           │
│       Token by Token     │
└──────────────────────────┘
 │
 ├───────────────┐
 ↓               ↓
Reasoning      Tool Call
 │               │
 └───────┬───────┘
         ↓
    More Inference
         │
         ↓
Safety / Policy
         │
         ↓
Streaming
         │
         ↓
Usage / Billing
         │
         ↓
Observability
         │
         ↓
User
如果采用 Prefill/Decode 分离的 Serving 架构,中间的 Inference 又可以展开成:
                    ┌───────────────┐
                    │ Prefill Pool  │
                    └───────┬───────┘
                            │
                         KV Cache
                            │
                            ↓
Request → Router → ┌───────────────┐
                   │  Decode Pool  │
                   └───────────────┘
这时候再看“调用一个 LLM API”这件事情,会发现它已经远远超出了一个模型文件本身。
模型只是其中最核心的一块。
围绕它运行的,还有 GPU、Memory、Cache、Network、Router、Scheduler、Tool、Policy、Billing 和 Observability。
写在最后
调用一个 LLM API,看起来可能只有一行代码:
response = client.responses.create(...)但这行代码背后,是一整条系统链路。
网络把请求送进来,
Gateway 完成认证和限流;
Router 决定请求去哪里;
Tokenizer 把文字转换成 Token;
Prefill 建立上下文状态;
KV Cache 保存可以复用的信息;
Decode 一个 Token 一个 Token 地生成结果。
如果模型需要 Reasoning 或 Tool Use,流程还会继续向外延伸。
最后,结果经过 Streaming 返回客户端,同时留下 Usage、Latency、Cost 和 Trace 数据。
这也是理解 LLM API 内部机制的意义。
以后看到一个 API 请求变慢,可以去看 TTFT、Queue、Prefill、Decode、Cache 和 Tool Call。
成本突然上涨,可以从 Input、Cached、Reasoning、Output Token 一路查下去。
429 增多,可以回到 Rate Limit 和 Capacity。
同样的 Prompt 有时快、有时慢,可以看看 Routing、Batching、Cache Locality 和当前系统负载。
当这些东西逐渐串起来之后,LLM API 就没有那么神秘了。
你看到的仍然是一句话和一个答案。
只是从工程角度看,中间已经站着一整套系统。